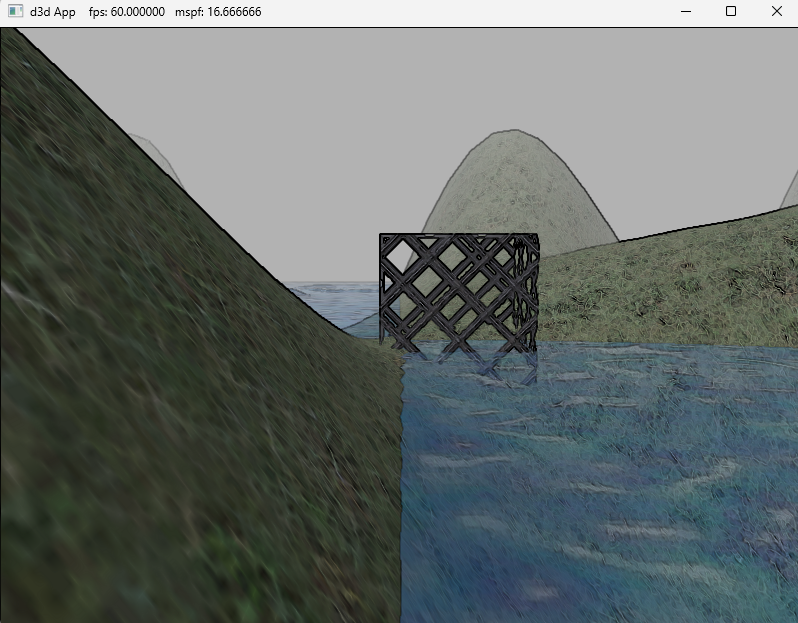
[3D Programming with DirectX12] Chapter 13 : The Compute Shader
DirectX12의 Comput Shader에 대해 소개합니다.
Compute Shader 개요
그래픽스 분야에서 활발히 연구를 진행하던 시기에 혹자는 이런 생각을 했다.
GPU를 화면 그리는데만 쓰는게 아니라 다른데도 쓰면 안되나 …?
GPU은 단순한 연산을 병렬로 처리하는데에 특화되어 있는데 이러한 특성을가진 계산에 GPU를 같이 사용한다면 효율이 늘어날 것이다.
이러한 아이디어를 기반으로 나온 것이 바로 Compute Shader이다.
스레드와 스레드 그룹
GPU에서의 스레드는 최소작업단위 1개를 의미하고, 스레드들이 일정한 개수로 모인 것을 스레드 그룹이라고 한다.
컴퓨트 셰이더에서 스레드들은 여러 개의 스레드 그룹으로 나뉘고, 각 그룹은 같은 동기화된 공유 메모리를 가질 수 있다. 다른 그룹끼리는 당연히 공유되지 않는다.
Direct3D에서는 스레드 그룹 크기를 32의 배수가 아닌 크기로 지정할 수도 있지만 성능상의 이유로 스레드 그룹의 크기는 32의 배수로 설정하는게 좋다.
간단한 컴퓨트 셰이더 코드
기본 CS
1
2
3
4
5
6
7
8
9
10
11
Texture2D gInputA;
Texture2D gInputB;
RWTexture2D<float4>	gOutput;

[numthreads(16,	16,	1)]
void CS(int3 dispatchThreadID :	SV_DispatchThreadID)
{
    gOutput[dispatchThreadID.xy] =
    gInputA[dispatchThreadID.xy] +
    gInputB[dispatchThreadID.xy];
}
두 개의 배열을 합치는 아주 기본적인 컴퓨트 셰이더 코드이다.
- Texture2D는 읽기 전용, RWTexture2D는 읽기,쓰기 모드 가능.
- x축 16개, y축 16개, z축 1개 (그룹 당 256개 스레드)
- dispatchTrheadID : 현재 스레드의 절대 좌표
연결 방법은 다른 셰이더와 마찬가지로 전용 PSO(Pipeline State Object)를 통해 가능하다.
스레드 식별 시스템
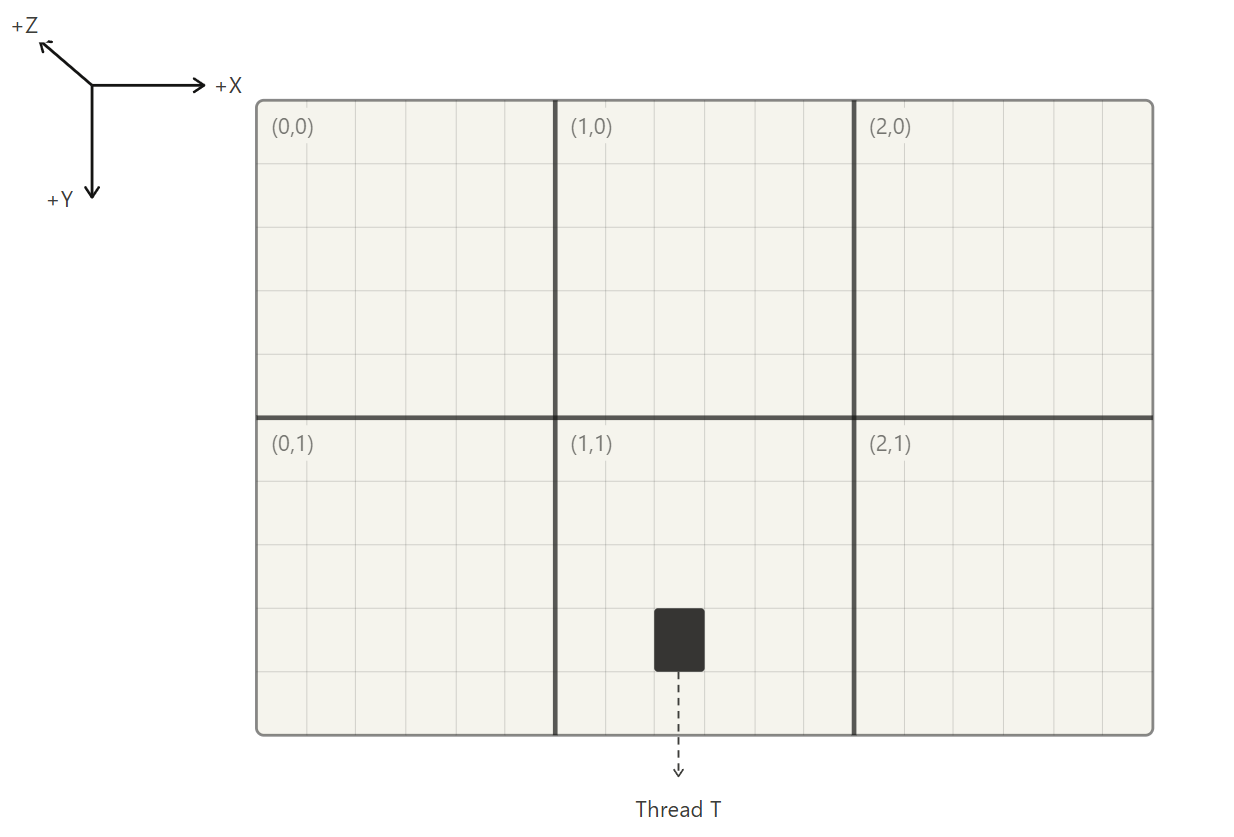
해당 스레드 그룹 그림을 보며 세 가지 식별자를 알아보자.
- SV_groupID : 전체 디스패치 공간에서 내 그룹이 몇 번째인가. Thread T가 속한 그룹은 (1,1)이다.
- SV_GroupThreadID : 내 그룹 안에서 몇 번째 스레드인지. Thread T는 (2,3)이다.
- SV_DispatchThreadID : SV_GroupID * numthreads + SV_GroupThreadID, Thread T는 (8, 8)이다.
Append & Consume 버퍼
Particle / Append & Consume CS
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
struct Particle
{
    float3 Position;
    float3 Velocity;
    float3 Acceleration;
};

float TimeStep = 1.0f / 60.0f;

ConsumeStructuredBuffer<Particle> gInput;
AppendStructuredBuffer<Particle> gOutput;

[numthreads(16,	16,	1)]
void CS()
{
    Particle p = gInput.Consume();
    p.Velocity += p.Acceleration*TimeStep;
    p.Position += p.Velocity*TimeStep;
    gOutput.Append(	p);
}
Consume과 Append 버퍼는 컴퓨트 셰이더에서 제공하는 특수한 버퍼타입이다. 이 두 버퍼는 인덱스로 접근하지 않고 스택이나 큐처럼 인덱스 없이 데이터를 꺼내거나 집어넣는 방식이다. 중요한 점은 계산과정에서 데이터의 순서를 보장하지 않는다.
또한 해당 버퍼는 동적으로 크기가 늘어나지 않으므로 슬롯을 미리 할당하므로 각 요소가 독립적으로 처리될 수 있는 경우에만 사용하는 것이 좋다.
공유 메모리 & Synchronization
스레드 그룹에는 공유 메모리라고 불리는 전용 메모리 영역이 할당된다. 해당 메모리는 하드웨어 캐시와 비슷한 수준으로 빠르다.
하나의 스레드 그룹이 같은 메모리를 공유하게 된다면 포스트 프로세싱(ex. 블러처리)같은 작업에 유용하게 쓰일 수 있다.
공유 메모리 CS
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
Texture2D gInput;
RWTexture2D gOutput;
groupshared float4 gCache[256];

[numthreads(256, 1, 1)]
void CS(int3 groupThreadID : SV_GroupThreadID,
        int3 dispatchThreadID : SV_DispatchThreadID)
{

    gCache[groupThreadID.x] = gInput[dispatchThreadID.xy];

    GroupMemoryBarrierWithGroupSync();

    float4 left  = gCache[groupThreadID.x - 1];
    float4 right = gCache[groupThreadID.x + 1];
    …
}
✨ 주의사항
그룹 내 모든 스레드는 동시에 처리된다는 보장이 없다. 따라서 같은 메모리에 여러 스레드들이 접근하므로 울타리를 걸어준다.
GroupMemoryBarrierWithGroupSync() 명령어는 모든 스레드가 완료될 때까지 기다리게하는 코드이다.
Blur 구현해보기
화면을 흐리게 만드는 블러처리를 컴퓨트 셰이더를 이용해 구현해보자. 수학적인 내용은 따로 빼서 설명하는게 좋을 것 같고, 컴퓨터 셰이더로 구현하는 부분만 간략하게 설명하겠다.
어릴 때 파스텔로 그림을 그리고 손으로 비비면 더 흐릿해지는 것을 경험했을 것이다. Blur처리는 이와 같은 원리로 중앙 픽셀의 색을 주변 색과 섞어서 구현한다.
각 픽셀의 가중치는 Gaussian function을 사용해서 11개의 가중치값을 구하고, 가로로 한번, 세로로 한번 계산한다.
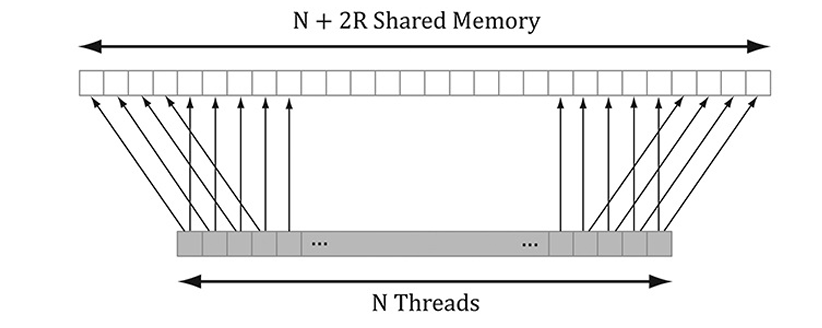
공유메모리는 N + 2R이다. 만약에 1920*1080 화면에 가우시안 가중치가 11개라면 가로 blur를 위해 필요한 공유메모리 인덱스는 1930칸이다.
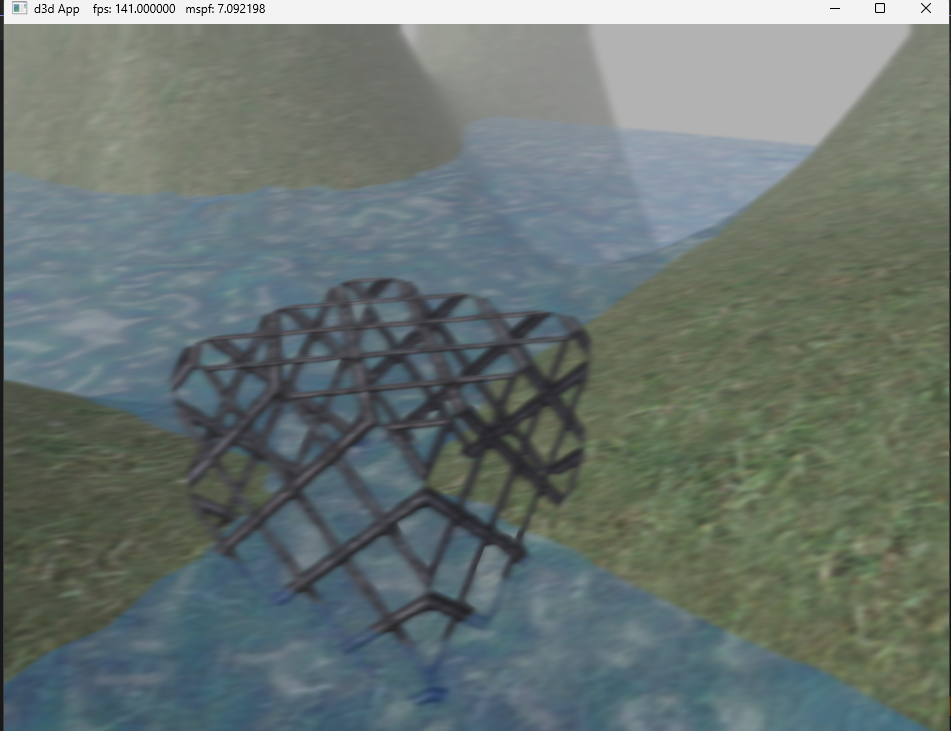
Blur처리가 잘 된것을 알 수 있다.
문제 풀이
1. 컴퓨트 셰이더를 이용해서 Sobel Operator 구현하기
Sobel Operator은 주변 픽셀과의 색상차이를 분석해서 엣지를 추출하는 필터이다. 수식적인 차이는 있지만 구현 방식은 blur와 크게 다르지 않다.
SobelCS
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
Texture2D gInput            : register(t0);
RWTexture2D<float4> gOutput : register(u0);

float CalcLuminance(float3 color)
{
    return dot(color, float3(0.299f, 0.587f, 0.114f));
}

[numthreads(16, 16, 1)]
void SobelCS(int3 dispatchThreadID : SV_DispatchThreadID)
{

	float4 c[3][3];
	for(int i = 0; i < 3; ++i)
	{
		for(int j = 0; j < 3; ++j)
		{
			int2 xy = dispatchThreadID.xy + int2(-1 + j, -1 + i);
			c[i][j] = gInput[xy];
		}
	}

	float4 Gx = -1.0f*c[0][0] - 2.0f*c[1][0] - 1.0f*c[2][0] + 1.0f*c[0][2] + 2.0f*c[1][2] + 1.0f*c[2][2];

	float4 Gy = -1.0f*c[2][0] - 2.0f*c[2][1] - 1.0f*c[2][1] + 1.0f*c[0][0] + 2.0f*c[0][1] + 1.0f*c[0][2];

	float4 mag = sqrt(Gx*Gx + Gy*Gy);
	mag = 1.0f - saturate(CalcLuminance(mag.rgb));

	gOutput[dispatchThreadID.xy] = mag;
}